- Actualizado: octubre 21, 2026
Qué es un LLM local y cuándo conviene usar IA sin internet
Un LLM local es un modelo de lenguaje, del mismo tipo que los que hacen funcionar a ChatGPT o Claude, que se ejecuta en tu propia computadora o en un servidor que tú controlas, en lugar de en los servidores de una empresa. Lo que escribes no sale de tu equipo, funciona sin conexión a internet y no pagas por cada consulta. A cambio, la calidad y la velocidad dependen de tu hardware 💻
Respuesta corta: un LLM local es un modelo de inteligencia artificial de texto que descargas y ejecutas en tu computadora con herramientas como Ollama o LM Studio. Sus ventajas son la privacidad, el uso sin internet y el costo fijo. Sus límites: necesita memoria suficiente y, en tareas complejas, suele rendir menos que los modelos más grandes de la nube.
Esta guía no empieza por la instalación, sino por la decisión: qué es exactamente un modelo local, cómo funciona, en qué casos le gana a la nube y en cuáles no, qué hardware necesitas y qué modelos abiertos existen. Si después decides probarlo, tienes nuestra guía de cómo instalar Ollama en Windows, Mac y Linux con el paso a paso.
¿Quieres correr tu propia IA en tu computadora, sin depender de la nube?
Qué es un LLM local
LLM son las siglas de large language model, modelo de lenguaje grande: un programa entrenado con enormes cantidades de texto que aprende a predecir la siguiente palabra y, gracias a eso, puede responder preguntas, resumir, traducir o escribir código. Si quieres el panorama general, empieza por qué es la inteligencia artificial.
Cuando usas ChatGPT en el navegador, el modelo vive en los centros de datos de OpenAI: tu mensaje viaja por internet, se procesa allí y la respuesta vuelve. Un LLM local invierte esa lógica: el modelo es un archivo que descargas una vez y que se ejecuta con el procesador, la tarjeta gráfica y la memoria de tu propio equipo. A partir de ahí, puede funcionar con el cable de red desconectado.
Esto es posible porque varias empresas y laboratorios publican modelos de pesos abiertos (open weights): ponen a disposición el archivo del modelo entrenado para que cualquiera lo descargue y lo ejecute según los términos de su licencia. Ejemplos conocidos son las familias Llama (Meta), Gemma (Google), Qwen (Alibaba), DeepSeek y Mistral, y desde agosto de 2025 también los modelos gpt-oss de OpenAI.
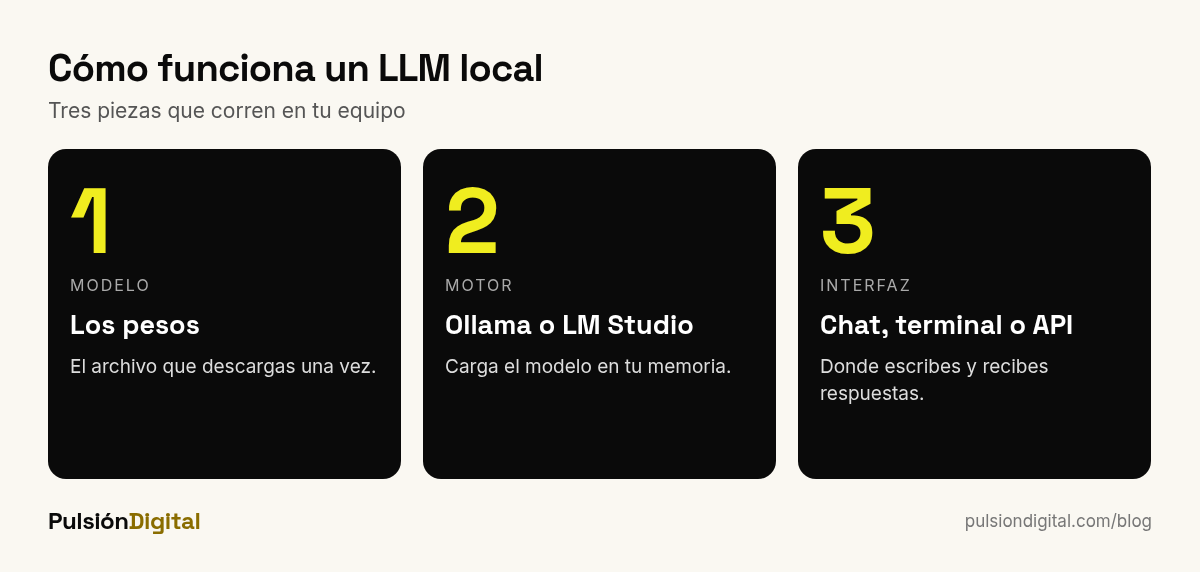
Los tres componentes de un LLM local
- El modelo: el archivo con los pesos, que puede ocupar desde un par de gigabytes hasta decenas.
- El motor de ejecución: el programa que carga el modelo en memoria y genera las respuestas. Ollama y LM Studio son los más usados por personas que empiezan.
- La interfaz: la forma en que hablas con él. Puede ser la terminal, una ventana de chat o una API local. Ollama, por ejemplo, expone su API en
http://localhost:11434/api, y su documentación aclara que las peticiones locales no necesitan clave de acceso.
LLM local vs. ChatGPT y la nube
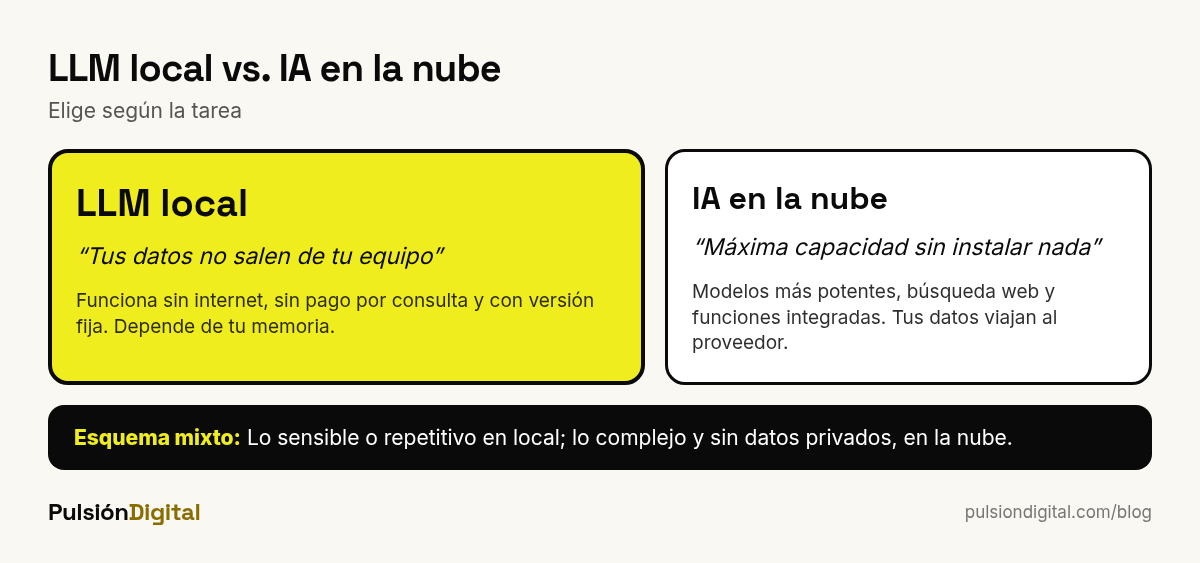
La pregunta útil no es cuál es «mejor», sino cuál conviene para cada tarea. Esta tabla resume las diferencias prácticas:
| Criterio | LLM local | IA en la nube (ChatGPT, Claude, Gemini) |
|---|---|---|
| Dónde se procesan tus datos | En tu equipo o tu servidor | En los servidores del proveedor |
| Funciona sin internet | Sí, una vez descargado el modelo | No |
| Costo | Hardware y electricidad; sin pago por consulta | Suscripción o pago por uso |
| Calidad en tareas complejas | Buena en modelos medianos; menor en razonamiento largo | Los modelos más capaces disponibles |
| Velocidad | Depende de tu memoria y tu tarjeta gráfica | Alta y estable |
| Puesta en marcha | Instalar, elegir modelo, ajustar | Abrir el navegador |
| Funciones extra | Las que configures tú | Búsqueda web, archivos, voz, agentes integrados |
| Control y personalización | Total: versión fija, sin cambios inesperados | El proveedor actualiza o retira modelos |
En resumen: la nube gana en comodidad y potencia; lo local gana en privacidad, independencia y costo predecible. Para conocer bien la opción en la nube, lee qué es ChatGPT y para qué sirve.
Por qué importa la privacidad: dos casos reales
La razón más citada para usar un modelo local es no enviar información sensible a terceros. Dos episodios de 2023 muestran por qué el tema dejó de ser teórico.
Italia bloquea ChatGPT por el tratamiento de datos
El 30 de marzo de 2023, el Garante para la protección de datos personales de Italia dispuso, con efecto inmediato, la limitación provisional del tratamiento de los datos de los usuarios italianos por parte de OpenAI. Entre los motivos señaló la falta de información a los usuarios, la ausencia de una base jurídica adecuada para recopilar datos personales con el fin de entrenar los algoritmos, la inexactitud de algunos datos tratados y la falta de verificación de la edad, aunque el servicio exigía tener al menos 13 años. Le dio 20 días para comunicar las medidas que adoptaría.
OpenAI suspendió el servicio en Italia y, tras cumplir varias exigencias (una política de privacidad más visible, un formulario para que los usuarios europeos se opusieran al uso de sus datos para entrenamiento y una verificación de edad para Italia), ChatGPT volvió a estar disponible en el país desde la tarde del 28 de abril de 2023.
Samsung restringe la IA generativa tras una filtración
Según informó Bloomberg el 2 de mayo de 2023, Samsung prohibió temporalmente a su personal usar herramientas de IA generativa como ChatGPT en dispositivos y redes de la empresa, después de detectar que se había subido código fuente interno a ChatGPT. La preocupación era que los datos enviados a esas plataformas quedan almacenados en servidores externos y son difíciles de recuperar y borrar.
Ninguno de los dos casos significa que la nube sea insegura por definición: los proveedores ofrecen planes empresariales con condiciones de datos específicas. Lo que muestran es que dónde se procesa la información es una decisión con consecuencias, y que un modelo local elimina por diseño el envío de datos a un tercero. Si trabajas con información sensible, complementa esta lectura con qué es la ciberseguridad.
Cuándo conviene un LLM local (y cuándo no)
Casos en los que lo local suele ganar
- Documentos confidenciales: contratos, historias clínicas, datos de clientes, código propietario o información financiera que no debe salir de la organización.
- Trabajo sin conexión: viajes, zonas con mala señal o entornos aislados de internet por seguridad.
- Tareas repetitivas de volumen alto: clasificar miles de correos o extraer datos de formularios, donde pagar por cada consulta se vuelve caro.
- Estabilidad: necesitas que el modelo se comporte igual dentro de seis meses, sin cambios de versión que no controlas.
- Aprender cómo funciona la IA por dentro: probar modelos, compararlos y entender sus límites.
Casos en los que la nube suele ser mejor
- Razonamiento complejo o tareas largas donde la diferencia de calidad con los modelos más grandes se nota.
- Información actualizada: un modelo local solo sabe lo que aprendió hasta su fecha de entrenamiento, salvo que le conectes tus propios documentos o una búsqueda.
- Equipos modestos: si tu computadora tiene 8 GB de RAM y la usas para otras cosas, la experiencia será lenta.
- Funciones integradas como voz, imágenes, búsqueda web o agentes listos para usar.
Muchas personas terminan en un esquema mixto: lo sensible o repetitivo en local y lo complejo, sin datos privados, en la nube.
Qué hardware necesitas para un LLM local
El factor clave es la memoria: el modelo tiene que caber en la RAM (o en la memoria de la tarjeta gráfica) para funcionar con fluidez. Por eso el tamaño del modelo, medido en miles de millones de parámetros (la «B» de 7B o 20B), es lo primero que hay que mirar.
Una referencia clásica es la que daba el propio repositorio de Ollama: al menos 8 GB de RAM para modelos de 7B, 16 GB para los de 13B y 32 GB para los de 33B. Es una guía orientativa, porque los modelos se distribuyen cuantizados, es decir, con los números que los componen guardados con menos precisión para que ocupen menos memoria a costa de una pequeña pérdida de calidad.
Un ejemplo reciente: según su ficha técnica, gpt-oss-20b de OpenAI tiene 21.000 millones de parámetros en total, de los que se activan 3.600 millones por cada palabra generada, y está pensado para funcionar dentro de 16 GB de memoria gracias a la cuantización. Se publicó con licencia Apache 2.0, que permite usarlo también con fines comerciales.
| Tu equipo | Qué puedes esperar | Uso recomendado |
|---|---|---|
| 8 GB de RAM | Modelos pequeños (hasta unos 7B cuantizados), respuestas más lentas | Probar, resumir textos cortos, aprender |
| 16 GB de RAM o Mac con 16 GB de memoria unificada | Modelos medianos con fluidez razonable | Redacción, resúmenes, preguntas sobre documentos |
| 32 GB o más, o tarjeta gráfica dedicada con mucha memoria | Modelos más grandes y respuestas rápidas | Uso diario intensivo, programación, equipos pequeños |
| Servidor propio | Un modelo disponible para varias personas a la vez | Empresas que quieren centralizar el uso con datos bajo control |
Las Mac con chips Apple Silicon suelen rendir bien porque la memoria es compartida entre el procesador y la parte gráfica. En Windows y Linux, una tarjeta gráfica con memoria dedicada acelera mucho las respuestas.
Modelos abiertos que puedes usar en local
El catálogo cambia cada pocos meses, así que más que una lista cerrada conviene conocer las familias principales y qué mirar en cada una:
- Llama (Meta): una de las familias más difundidas, con muchas variantes ajustadas por la comunidad.
- Gemma (Google): modelos compactos pensados para equipos modestos.
- Qwen (Alibaba) y DeepSeek: modelos abiertos de origen chino, con variantes de distintos tamaños y algunas especializadas en programación.
- Mistral: modelos europeos de tamaños variados.
- gpt-oss (OpenAI): modelos de pesos abiertos con licencia Apache 2.0.
Antes de elegir, revisa tres cosas en la ficha del modelo: su tamaño (¿cabe en tu memoria?), su licencia (¿permite el uso que quieres darle?) y su idioma (algunos responden mejor en inglés que en español).
Cómo empezar con un LLM local en 4 decisiones
- Define la tarea. «Resumir actas de reuniones internas» es mejor punto de partida que «tener una IA en mi computadora».
- Revisa tu memoria. En Windows, el Administrador de tareas; en Mac, «Acerca de esta Mac». Eso define el tamaño de modelo posible.
- Elige el motor. Si prefieres una ventana gráfica, LM Studio; si te sientes cómodo con la terminal o quieres conectarlo a otras herramientas, Ollama. El paso a paso está en nuestra guía de instalación de Ollama.
- Compara con la nube. Haz la misma tarea con tu modelo local y con un servicio en la nube usando datos no sensibles. Así sabes si la calidad te alcanza.
Los modelos locales responden mejor con instrucciones claras y concretas que los grandes modelos de la nube, que toleran más ambigüedad. Por eso vale la pena repasar qué es un prompt y cómo escribirlo bien.
Ejercicio práctico: decide si te conviene un LLM local
Responde estas cinco preguntas sobre una tarea concreta de tu trabajo. Suma un punto por cada «sí»:
- ¿La tarea usa información que no debería salir de tu equipo o de tu empresa?
- ¿La haces muchas veces por semana?
- ¿Necesitas hacerla a veces sin internet?
- ¿Tu computadora tiene 16 GB de memoria o más?
- ¿La tarea es acotada (resumir, clasificar, extraer, reescribir) y no requiere razonamiento largo?
4 o 5 puntos: un LLM local es un candidato fuerte; pruébalo esta semana. 2 o 3 puntos: esquema mixto; empieza por la parte sensible en local. 0 o 1 punto: por ahora la nube te resolverá mejor; si el motivo es el hardware, revisa la opción de un servidor propio.
Mitos y errores comunes sobre los LLM locales
«Si es local, es automáticamente privado»
El modelo no envía tus textos a nadie, pero la privacidad también depende del resto del equipo. Si tu computadora no tiene contraseña, el disco no está cifrado o compartes la carpeta donde guardas las conversaciones, la información sigue expuesta. Y si instalas una interfaz de terceros, revisa si esa interfaz tiene funciones que se conectan a internet.
«Un modelo local sabe lo mismo que ChatGPT»
Un modelo de 7B o 20B tiene mucha menos capacidad que los modelos más grandes de la nube. Puede responder con seguridad cosas incorrectas, igual que cualquier IA, y a veces con más frecuencia. Verifica los datos importantes y usa el modelo local para tareas en las que tú puedes juzgar el resultado.
«Hace falta una computadora gamer carísima»
Para empezar, no. Una computadora con 16 GB de memoria ya permite probar modelos medianos con resultados útiles. El hardware potente marca la diferencia en velocidad y en el tamaño de modelo que puedes usar, pero no es requisito para aprender.
«Descargo cualquier modelo y listo»
Cada modelo tiene una licencia distinta. Algunas permiten el uso comercial sin restricciones, como Apache 2.0, y otras ponen condiciones. Si vas a usarlo en tu empresa o en un producto, lee los términos antes. Descarga los modelos desde fuentes oficiales, como la biblioteca de Ollama o la página del fabricante en Hugging Face.
«Lo instalo una vez y me olvido»
Los modelos abiertos mejoran rápido. Cada pocos meses aparecen versiones que rinden más con el mismo hardware. Conviene revisar de vez en cuando si hay un modelo mejor para tu tarea, comparándolo con el que ya usas antes de cambiar.
Un paso más: el LLM local en tu flujo de trabajo
Una vez que el modelo funciona, el siguiente nivel es conectarlo con tus herramientas. Como Ollama ofrece una API local, puedes llamarlo desde un script, una planilla o un automatizador para procesar documentos sin que salgan de tu equipo. También puedes conectarle tus propios archivos para que responda con base en ellos, una técnica conocida como RAG (generación aumentada por recuperación). Y si quieres que un asistente ejecute tareas por su cuenta, te interesará leer qué es un agente de IA.
Cómo lo aprendes en Pulsión Digital
En Pulsión Digital diseñamos el curso de IA Local con Ollama para quien quiere tomar esta decisión con criterio y no solo seguir un tutorial. El recorrido va desde por qué correr un modelo en tu propia computadora hasta instalar Ollama, descargar tu primer modelo, entender el tamaño del modelo y el hardware que necesitas, probar modelos abiertos como Qwen y DeepSeek, compararlos con Claude o ChatGPT, usarlos desde una interfaz visual, conectarlos a tus documentos y decidir cuándo conviene lo local y cuándo la nube.
- A tu propio ritmo, con clases breves y prácticas.
- Examen en cada clase para comprobar lo aprendido.
- Tutor con IA para resolver dudas sobre tu equipo y tu caso.
- Comunidad de personas con intereses parecidos.
- Certificado al terminar.
Si te preocupa la protección de datos en general, el curso de Ciberseguridad cubre contraseñas, autenticación multifactor, backups y respuesta ante incidentes. Y si quieres automatizar tareas con tu modelo local, el curso de Python con IA es el siguiente paso natural.
Preguntas frecuentes sobre los LLM locales
¿Qué es un LLM local en pocas palabras?
Es un modelo de lenguaje que descargas y ejecutas en tu propia computadora o servidor. Procesa tus textos sin enviarlos a internet y no cobra por consulta.
¿Un LLM local funciona sin internet?
Sí. Necesitas conexión para descargar el modelo y el programa, pero después puede funcionar con el equipo desconectado.
¿Es tan bueno como ChatGPT?
Depende de la tarea y del modelo. Para resumir, reescribir o clasificar, los modelos medianos funcionan bien. En razonamiento complejo, los modelos más grandes de la nube suelen rendir mejor.
¿Cuánta RAM necesito para un LLM local?
Como referencia, unos 8 GB para modelos de 7B, 16 GB para modelos de 13B y 32 GB para modelos de 33B. Los modelos cuantizados reducen esas necesidades.
¿Usar un LLM local es gratis?
Muchos modelos abiertos se descargan sin costo y no pagas por consulta, pero sí hay costos de hardware y electricidad. Revisa siempre la licencia de cada modelo.
¿Un LLM local es más seguro?
Evita enviar datos a un tercero, lo que reduce un riesgo importante. Pero la seguridad también depende de proteger tu equipo: contraseñas, cifrado del disco y copias de seguridad.
Conclusión
Un LLM local no reemplaza a la nube: es una herramienta distinta para un problema distinto. Si trabajas con información sensible, necesitas funcionar sin conexión o haces tareas repetitivas a gran volumen, tener un modelo en tu computadora te da control, privacidad y un costo predecible. Si buscas la máxima capacidad sin complicarte, la nube sigue siendo más cómoda. La decisión empieza por la tarea y por tu memoria disponible, no por la moda. Haz el ejercicio de cinco preguntas y, si el resultado te dice que vale la pena, el curso de IA Local con Ollama te acompaña desde la instalación hasta integrarlo en tu trabajo diario.
Fuentes consultadas
- Garante per la protezione dei dati personali (2023). Provvedimento del 30 marzo 2023 [9870832].
- Il Post (28 de abril de 2023). ChatGPT è di nuovo raggiungibile dall’Italia.
- MobileSyrup, con información de Bloomberg (2 de mayo de 2023). Samsung bans employee use of AI tools after sensitive data leak.
- OpenAI. Ficha del modelo gpt-oss-20b (Hugging Face).
- Ollama. README del repositorio (requisitos de memoria) y documentación de la API.