- Actualizado: noviembre 18, 2026
Qué es RAG en inteligencia artificial y cómo usarlo en local
Qué es RAG en inteligencia artificial es una pregunta que vale la pena hacerse si alguna vez un chatbot te respondió con total seguridad algo que era falso. RAG es la técnica que hace que la IA, antes de responder, busque en tus documentos y conteste apoyándose en lo que encontró, en lugar de improvisar con lo que «recuerda». En esta guía te lo explicamos sin jerga, con un caso real que muestra por qué importa y con un camino práctico para hacerlo en tu propia computadora, sin subir contratos ni datos sensibles a la nube 🔎
Respuesta corta: RAG (Retrieval-Augmented Generation, o generación aumentada por recuperación) es una técnica en la que un modelo de lenguaje primero busca fragmentos relevantes en una colección de documentos y después redacta la respuesta usando esos fragmentos como base, idealmente citándolos. Reduce las respuestas inventadas, permite usar información privada o actualizada y no exige reentrenar el modelo.
Vas a ver de dónde sale el término, cómo funciona paso a paso, qué son los embeddings y las bases de datos vectoriales, en qué se diferencia de ajustar un modelo, el caso de Air Canada, cuándo conviene hacerlo en local con Ollama, cómo montarlo sin programar y un ejercicio para probarlo con tus propios archivos.
¿Quieres correr la IA en tu computadora y conectarla a tus propios documentos?
Qué es RAG en inteligencia artificial, sin jerga
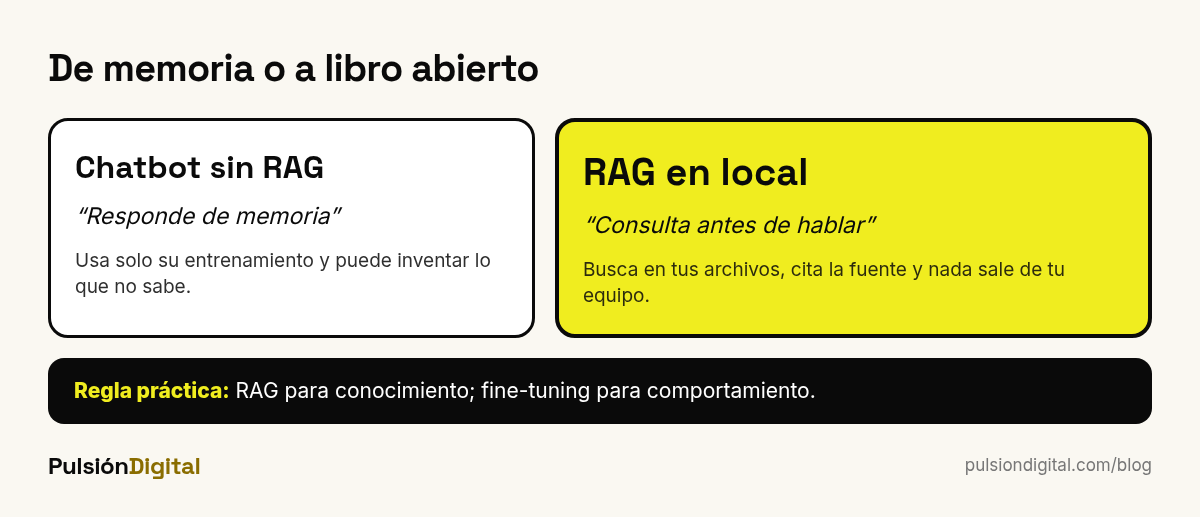
Piensa en la diferencia entre un examen de memoria y un examen a libro abierto. Un modelo de lenguaje «normal», como el que hay detrás de un chatbot, responde de memoria: usa lo que aprendió durante su entrenamiento. Si la respuesta no estaba en esos datos, o estaba pero cambió, puede rellenar el hueco con algo que suena bien y es falso. Es lo que se conoce como alucinación.
Con RAG, el modelo hace el examen a libro abierto. Antes de contestar, un buscador revisa tus documentos (manuales, contratos, políticas, notas, correos), elige los fragmentos más relacionados con la pregunta y se los entrega al modelo junto con una instrucción del tipo: «responde usando solo esta información y di de dónde sale». El modelo sigue redactando con su capacidad de lenguaje, pero ahora con los datos correctos delante.
Si quieres repasar qué es exactamente un modelo de lenguaje antes de seguir, tienes nuestra guía sobre qué es la inteligencia artificial.
De dónde viene el término RAG
El nombre viene del artículo Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, de Patrick Lewis y otros once autores, publicado en mayo de 2020 y presentado en la conferencia NeurIPS 2020. El trabajo salió de Facebook AI Research, el laboratorio de investigación en IA de la actual Meta.
El punto de partida del artículo es el mismo problema que ves hoy en cualquier chatbot: los grandes modelos de lenguaje guardan conocimiento en sus parámetros, pero su capacidad para acceder a ese conocimiento y manipularlo con precisión es limitada. La propuesta fue combinar dos tipos de memoria:
- Memoria paramétrica: lo que el modelo aprendió en su entrenamiento.
- Memoria no paramétrica: un índice de documentos externos (en el artículo, Wikipedia) al que se accede con un buscador neuronal.
Según los autores, los modelos RAG lograron resultados de vanguardia en preguntas de dominio abierto y generaron un lenguaje más específico y más ajustado a los hechos que los modelos que solo usaban su memoria interna. La idea se volvió tan útil que hoy «RAG» se usa para casi cualquier sistema que combine búsqueda y generación.
Cómo funciona RAG paso a paso
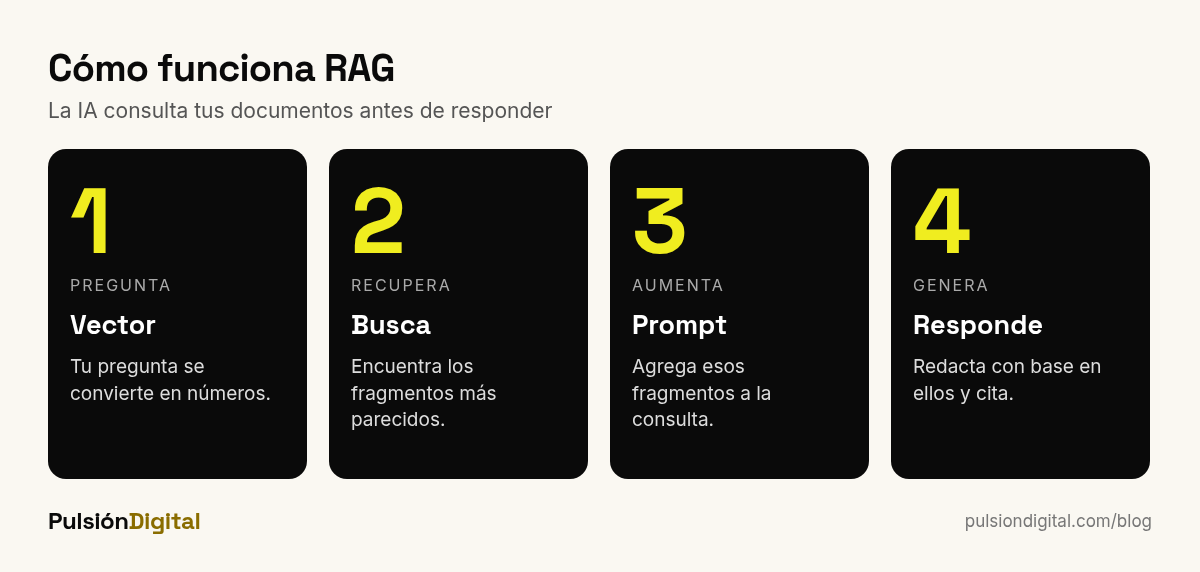
Un sistema RAG tiene dos fases: preparar los documentos (una vez) y responder (cada vez que preguntas).
Fase 1: preparar los documentos (indexar)
- Cargar. Se reúnen los archivos: PDF, Word, páginas web, notas.
- Trocear. Cada documento se divide en fragmentos (chunks) de unos pocos párrafos. Así el buscador puede encontrar la parte exacta y no el documento entero.
- Convertir en vectores. Un modelo de embeddings transforma cada fragmento en una lista de números que representa su significado.
- Guardar. Esos vectores se almacenan en una base de datos vectorial, junto con el texto original y de qué archivo salió.
Fase 2: responder (recuperar y generar)
- Tu pregunta también se convierte en vector con el mismo modelo de embeddings.
- Búsqueda por similitud. La base de datos devuelve los fragmentos cuyo significado se parece más al de tu pregunta, aunque no usen las mismas palabras.
- Aumentar el prompt. Esos fragmentos se insertan en el mensaje que recibe el modelo, junto con tu pregunta y la instrucción de basarse en ellos.
- Generar. El modelo redacta la respuesta y, si está bien configurado, indica de qué documento sale cada dato.
Embeddings y bases de datos vectoriales, explicados fácil
Esta es la parte que más asusta y la más sencilla de entender con una imagen. Un embedding es como una dirección en un mapa de significados. Los textos que hablan de lo mismo quedan cerca, aunque usen palabras distintas: «¿puedo devolver el producto?» y «política de reembolsos» terminan en el mismo barrio del mapa.
La documentación de Ollama lo resume así: los embeddings convierten texto en vectores numéricos que puedes guardar en una base de datos vectorial, buscar por similitud y usar en sistemas RAG. Una base de datos vectorial es simplemente un almacén optimizado para responder rápido a la pregunta «¿qué fragmentos están más cerca de este punto del mapa?».
La ventaja frente a una búsqueda por palabras clave es que entiende sinónimos y paráfrasis. La desventaja es que a veces trae fragmentos parecidos pero irrelevantes, por eso conviene revisar qué fuentes usó la respuesta.
RAG frente a fine-tuning y frente a «pegarlo todo en el prompt»
Hay tres formas habituales de darle a la IA información que no trae de fábrica. Esta tabla te ayuda a elegir:
| Enfoque | Qué hace | Ventajas | Limitaciones | Úsalo cuando |
|---|---|---|---|---|
| Pegar el documento en el prompt | Copias el texto completo en la conversación | Inmediato, sin montar nada | Solo sirve para pocos documentos; consume contexto | Tienes uno o dos archivos cortos |
| RAG | Busca fragmentos relevantes y los entrega al modelo en cada pregunta | Escala a miles de documentos, se actualiza al instante, permite citar fuentes | Depende de que la búsqueda encuentre el fragmento correcto | Quieres consultar una base de conocimiento que cambia |
| Fine-tuning (ajuste fino) | Reentrena el modelo con ejemplos propios | Cambia estilo, formato o comportamiento de forma estable | Más caro y técnico; actualizar datos exige reentrenar; no cita fuentes | Quieres que el modelo escriba o se comporte de una forma concreta |
Una regla práctica: RAG para conocimiento, fine-tuning para comportamiento. Si lo que necesitas es que la IA sepa qué dice tu contrato o tu manual interno, casi siempre la respuesta es RAG.
Caso real: el chatbot de Air Canada y la política inventada
En noviembre de 2022, tras la muerte de su abuela, Jake Moffatt consultó el chatbot de la web de Air Canada sobre las tarifas por duelo. El chatbot le indicó que podía pedir ese descuento de forma retroactiva, después de viajar. Moffatt compró los billetes a precio normal y luego solicitó la diferencia. La aerolínea se negó: su política real, publicada en otra página de la misma web, no admitía solicitudes una vez completado el viaje.
En febrero de 2024, el Tribunal de Resolución Civil de Columbia Británica (Canadá) resolvió el caso Moffatt v. Air Canada a favor del pasajero. Air Canada argumentó, en la práctica, que el chatbot era responsable de sus propias acciones. El tribunal lo calificó de «argumento notable» y respondió que debería ser obvio para la aerolínea que es responsable de toda la información de su web, venga de una página estática o de un chatbot. La empresa tuvo que pagar 650,88 dólares canadienses en concepto de daños, más intereses y costas.
¿Qué tiene que ver con RAG? El chatbot dio una respuesta que contradecía el documento oficial de la propia empresa. Un sistema bien diseñado de recuperación habría buscado primero la política de tarifas por duelo, la habría puesto delante del modelo y le habría pedido responder solo con base en ella y citarla. RAG no hace infalible a ninguna IA, pero ataca justo ese problema: que la respuesta salga de tus documentos y no de la imaginación del modelo.
Para qué sirve RAG: usos concretos
- Atención al cliente: respuestas basadas en las políticas y manuales vigentes, con enlace a la fuente.
- Documentación interna: «¿cómo se pide un reembolso de gastos?» respondido con el procedimiento actual de la empresa.
- Contratos y documentos legales: localizar cláusulas, plazos y obligaciones en decenas de archivos.
- Investigación y estudio: preguntar a tu biblioteca de artículos o apuntes y obtener respuestas con referencias.
- Soporte técnico: buscar en manuales de producto y registros de incidencias anteriores.
- Agentes de IA: un agente que necesita consultar información antes de actuar suele usar un paso de recuperación.
Herramientas como Gemini Notebook, la antigua NotebookLM, aplican esta misma lógica en la nube: subes tus fuentes y el asistente responde citándolas. La pregunta es qué pasa cuando esas fuentes no deberían salir de tu equipo.
Por qué hacer RAG en local: tus documentos no salen de tu computadora
Cuando usas un chatbot en la nube con tus archivos, esos archivos viajan a los servidores del proveedor. Para muchas tareas no es un problema, pero hay documentos que preferirías no subir: contratos con clientes, historiales médicos, datos financieros, información de empleados o cualquier cosa protegida por acuerdos de confidencialidad.
Con un LLM local, el modelo corre en tu propia computadora. Si además el modelo de embeddings y la base de datos vectorial también están en tu equipo, todo el circuito RAG ocurre sin conexión: tus documentos se indexan, se buscan y se resumen sin salir de tu disco.
| Criterio | RAG en la nube | RAG en local |
|---|---|---|
| Privacidad | Los documentos se envían al proveedor | Los documentos no salen de tu equipo |
| Calidad del modelo | Modelos más grandes y capaces | Depende de tu hardware; modelos más pequeños |
| Costo | Suscripción o pago por uso | Sin costo por consulta; usas tu computadora |
| Puesta en marcha | Inmediata | Requiere instalar y configurar |
| Funciona sin internet | No | Sí |
| Ideal para | Documentos públicos o poco sensibles | Contratos, datos personales, información confidencial |
No es todo o nada: muchas personas combinan ambos mundos y usan la nube para lo general y lo local para lo sensible.
Cómo montar un RAG local con Ollama (sin programar)
Ollama es la forma más sencilla de correr modelos en tu computadora, y su documentación incluye soporte para embeddings (en sus ejemplos usa el modelo embeddinggemma). Para tener una interfaz tipo chat con tus documentos, una opción popular es Open WebUI, que se conecta a Ollama.
1. Instala Ollama y descarga dos modelos
Uno para conversar y otro para embeddings. Desde la terminal, por ejemplo: ollama pull embeddinggemma y un modelo de chat que tu equipo pueda mover con soltura. Si no sabes cuál elegir según tu memoria RAM, revisa nuestra comparativa Ollama vs LM Studio.
2. Instala una interfaz visual
Open WebUI ofrece una pantalla de chat en el navegador conectada a tus modelos locales. Según su documentación, puedes subir archivos a una conversación o crear una base de conocimiento reutilizable en Workspace > Knowledge.
3. Carga tus documentos
Crea una base de conocimiento (por ejemplo, «Contratos 2026») y sube los archivos. La herramienta los trocea, calcula los embeddings y los guarda en su base vectorial.
4. Pregunta citando la base
En el chat, escribe # y elige la base de conocimiento o el documento, como indica la documentación de Open WebUI. Después haz tu pregunta: «¿Qué plazo de preaviso tiene el contrato con el proveedor X?».
5. Comprueba las fuentes
Revisa los fragmentos citados. Si la respuesta no coincide con el documento, el problema suele estar en la búsqueda (fragmentos mal cortados o pregunta ambigua), no en el modelo.
Y si quieres programarlo
Ollama expone una API local: el endpoint /api/embed en http://localhost:11434 devuelve los vectores de cualquier texto. Con unas decenas de líneas de Python puedes construir tu propio RAG, y con un agente como Claude Code puedes pedir que te ayude a escribirlo y explicarlo paso a paso.
Errores comunes y límites de RAG
- Creer que elimina las alucinaciones. Las reduce, no las hace desaparecer. El modelo todavía puede malinterpretar un fragmento o mezclar dos.
- Documentos desordenados. Si tu base tiene tres versiones del mismo manual, la IA puede citar la vieja. Mantén una sola versión vigente.
- Fragmentos mal cortados. Si una tabla queda partida en dos fragmentos, la respuesta saldrá incompleta. Los PDF escaneados sin texto seleccionable directamente no se pueden indexar sin pasarlos antes por reconocimiento de texto.
- Preguntas demasiado vagas. «Háblame del contrato» trae fragmentos al azar. «¿Qué penalización hay por cancelar antes de 12 meses?» trae el correcto.
- No pedir citas. Pide siempre que indique de qué documento sale cada dato. Si no puede citarlo, desconfía.
- Contexto corto en modelos locales. Los modelos locales pueden trabajar con ventanas de contexto pequeñas por defecto; si los fragmentos recuperados no caben, se pierde información. Revisa esa configuración en tu herramienta.
Escribir bien la pregunta importa tanto como el sistema. Si quieres afinar esa parte, mira nuestra guía sobre qué es un prompt.
Ejercicio práctico: tu primer «chatea con tus documentos»
| Paso | Qué haces | Qué observas |
|---|---|---|
| 1 | Elige 5 documentos que conozcas bien (por ejemplo, contratos, manuales o tus apuntes). | Así podrás detectar si la IA se equivoca. |
| 2 | Escribe 10 preguntas cuya respuesta sepas y anota en qué documento y página está. | Es tu «examen de control». |
| 3 | Haz las 10 preguntas a un modelo local sin documentos. | Cuántas inventa o deja sin responder. |
| 4 | Carga los 5 documentos en una base de conocimiento y repite las preguntas. | Cuántas acierta y si cita la fuente correcta. |
| 5 | Reformula las preguntas que falló para que sean más concretas. | Cuánto mejora con preguntas precisas. |
| 6 | Anota tus conclusiones: qué tipo de pregunta funciona y cuál no. | Tu propia guía de uso. |
Este pequeño experimento vale más que cualquier explicación: vas a ver con tus propios ojos la diferencia entre una IA que responde de memoria y una que consulta antes de hablar.
Cómo lo aprendes en Pulsión Digital
En Pulsión Digital creemos que la IA es más útil cuando tú controlas dónde vive y qué datos ve. El curso IA Local con Ollama te lleva desde la instalación hasta un sistema integrado en tu trabajo diario:
- Por qué correr un modelo de IA en tu propia computadora.
- Instalar Ollama paso a paso y correr tu primer modelo.
- El tamaño del modelo y el hardware que necesitas.
- Usar el modelo local desde una interfaz visual, no solo la terminal.
- Conectar el modelo local a tus propios documentos.
- Cuándo conviene lo local y cuándo seguir con la nube.
Lo haces a tu propio ritmo, con examen en cada clase, un tutor con IA que te ayuda cuando algo no funciona en tu equipo, una comunidad de personas con intereses parecidos y certificado al terminar.
Si quieres programar tu propio RAG, el curso de Python con IA te da las bases. Y si te interesa convertirlo en un agente que trabaje solo, el de Claude Code es el siguiente paso.
Preguntas frecuentes sobre RAG
¿Qué significa RAG en inteligencia artificial?
Significa Retrieval-Augmented Generation, en español generación aumentada por recuperación. Es una técnica en la que la IA busca primero información relevante en documentos y luego redacta la respuesta basándose en ella.
¿Para qué sirve RAG?
Sirve para que un modelo de lenguaje responda con información de tus documentos, privada o actualizada, en lugar de depender solo de su entrenamiento. Reduce las respuestas inventadas y permite citar las fuentes.
¿Cuál es la diferencia entre RAG y fine-tuning?
RAG le da al modelo información externa en cada consulta, sin modificarlo. El fine-tuning reentrena el modelo con ejemplos propios. RAG es mejor para conocimiento que cambia; el fine-tuning, para ajustar estilo o comportamiento.
¿RAG elimina las alucinaciones de la IA?
No las elimina, pero las reduce mucho, porque el modelo responde con los fragmentos encontrados delante. Conviene pedir siempre que cite la fuente y revisarla.
¿Se puede hacer RAG con Ollama en mi computadora?
Sí. Ollama permite correr un modelo de chat y uno de embeddings en local, y herramientas como Open WebUI añaden una interfaz para subir documentos y preguntar sobre ellos sin enviarlos a la nube.
¿Quién inventó RAG?
El término se popularizó con el artículo de Patrick Lewis y otros once autores, surgido de Facebook AI Research, publicado en 2020 y presentado en la conferencia NeurIPS 2020.
Conclusión
RAG es, en el fondo, una idea de sentido común aplicada a la IA: antes de responder, consulta. En lugar de fiarse de lo que el modelo recuerda, el sistema busca en tus documentos, le entrega los fragmentos relevantes y le pide que responda con ellos y cite de dónde salen. El caso de Air Canada muestra lo que cuesta un chatbot que contradice los documentos de su propia empresa. Y hacerlo en local con Ollama te permite aplicar esta técnica a contratos y datos sensibles sin que salgan de tu computadora. Haz el ejercicio con cinco documentos que conozcas y vas a entender, en una tarde, por qué RAG se volvió una de las técnicas más usadas de la IA aplicada.
Fuentes consultadas
- Lewis, P. et al. (2020). Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. NeurIPS 2020.
- Sookman, B. (16 de febrero de 2024). Moffatt v. Air Canada: a misrepresentation by an AI chatbot (reproduce la decisión 2024 BCCRT 149).
- Mondaq. Whose responsibility is it anyway? Chatbots and legal issues in Moffatt v. Air Canada.
- Ollama. Embeddings. Documentación oficial.
- Open WebUI. Retrieval Augmented Generation (RAG). Documentación oficial.